Transcribir entrevistas para investigación cualitativa: guía
Cómo transcribir entrevistas para investigación cualitativa: literal o literal limpia, convenciones, anonimización, privacidad y exportar a NVivo o MAXQDA.
También disponible en: English, Русский, Українська, Dansk, Deutsch, Français, Italiano, Magyar, Nederlands, Norsk bokmål, Polski, Português (Brasil), Suomi, Svenska, Türkçe, Ελληνικά, עברית, العربية, 한국어, 日本語, 中文(中国), 中文(台灣), Indonesia, Tiếng Việt
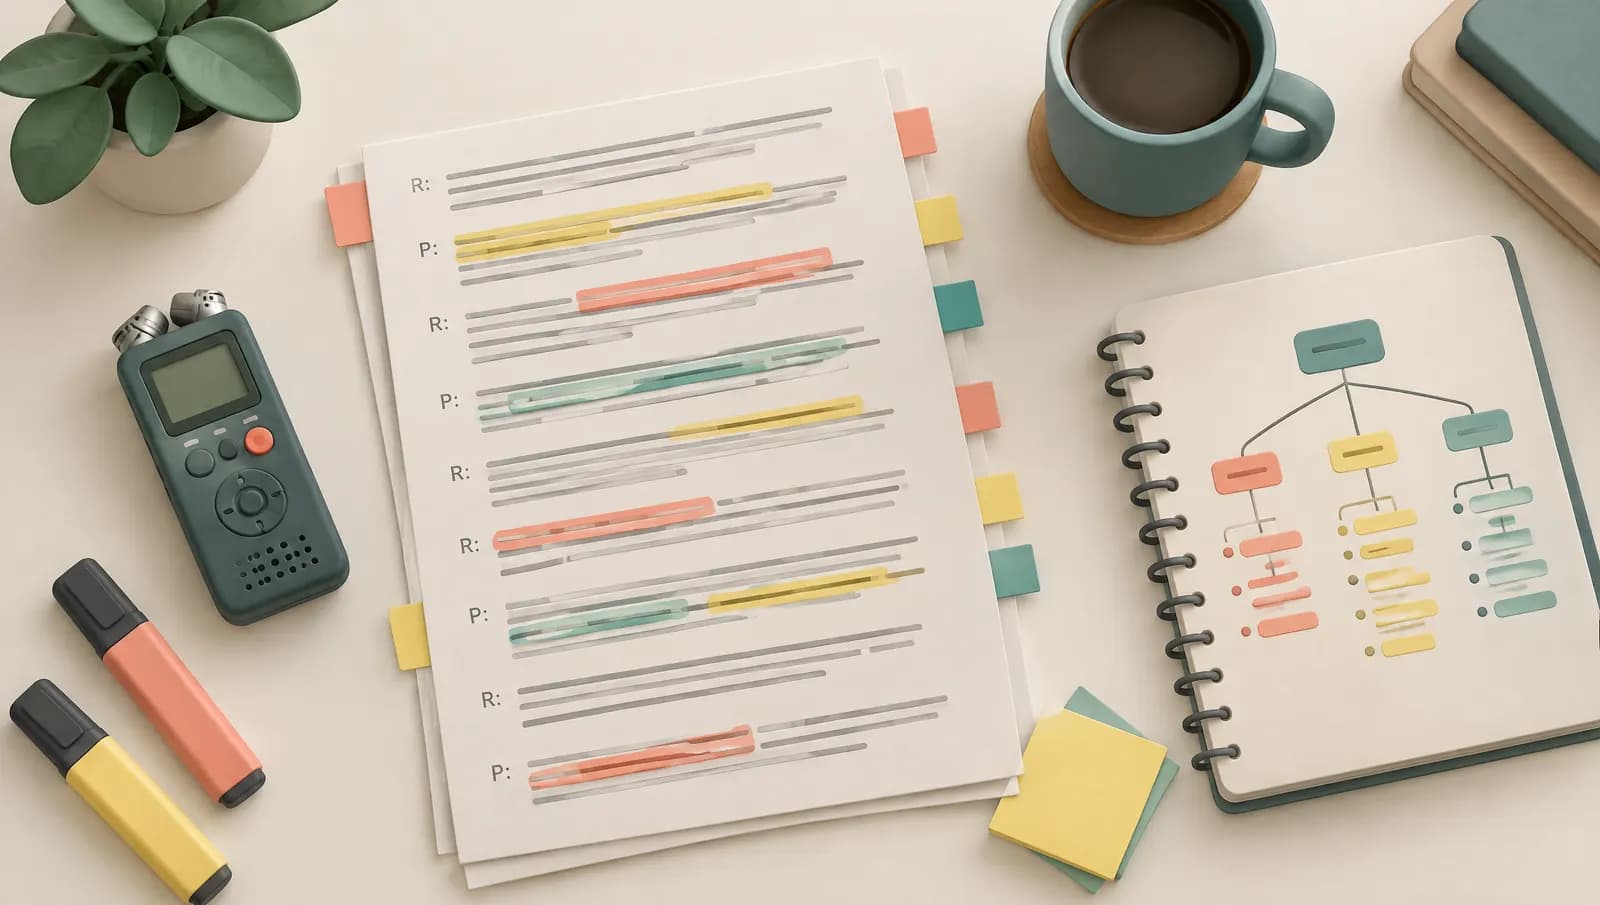
Transcribir entrevistas para investigación cualitativa significa convertir entrevistas o grupos focales en un texto que puedas analizar, citar y compartir de forma segura. En la práctica se reduce a cuatro decisiones: qué estilo de transcripción usar (literal, literal limpia o un sistema de notación), cómo anonimizar a los participantes, cómo revisar la exactitud y qué formato importa tu software de análisis. Esta guía cubre cada paso y termina con un flujo de trabajo para preparar la transcripción de una entrevista para codificarla.
Si necesitas lo básico para grabar y transcribir entrevistas de audio a texto en periodismo o investigación, empieza por nuestra guía para transcribir entrevistas. Este artículo profundiza en lo propio de la investigación: convenciones, ética, anonimización y software de codificación.
Literal vs literal limpia: primero elige un estilo
El estilo que elijas debe derivarse de tu método, y debe quedar por escrito antes de que alguien empiece a teclear. Cambiar las convenciones a mitad del proyecto obliga a revisar de nuevo todas las transcripciones anteriores.
| Estilo | Qué conserva | Qué elimina | Uso típico |
|---|---|---|---|
| Literal detallada (con notación) | Cada palabra, muletillas, arranques en falso, pausas, superposiciones, entonación, risas | Nada de forma deliberada | Análisis de la conversación, análisis del discurso |
| Literal (todo lo dicho, legible) | Cada palabra, muletillas ("eh", "este", "o sea"), repeticiones, frases sin terminar | El detalle de tiempos y entonación | Estudios narrativos e interpretativos, IPA |
| Literal limpia (verbatim inteligente) | Las palabras y el sentido de quien habla | Muletillas, tartamudeos, palabras repetidas, casi todos los arranques en falso | Análisis temático, investigación aplicada y de políticas públicas |
| Editada o resumen | Las ideas principales, parafraseadas | Casi toda la redacción original | Notas; por lo general no sirve como dato de investigación |
Elegir entre literal y literal limpia es, sobre todo, decidir qué cuenta como dato. Si la duda, la autocorrección o la forma en que alguien suaviza una afirmación importan para tu análisis, la literal limpia borra evidencia que necesitas. Si te interesan los temas a lo largo de 30 entrevistas, la literal completa agrega tiempo de lectura sin mucho valor analítico. En cualquier caso, la literal limpia nunca debe cambiar las palabras ni la gramática del participante más allá de quitar muletillas; no es una paráfrasis.
Convenciones de transcripción para investigación cualitativa
Las convenciones son las reglas que hacen que las transcripciones sean coherentes en todo el proyecto y entre distintas personas que transcriben. Hay dos opciones generales.
Convenciones sencillas
La mayoría de los estudios cualitativos usan una lista corta, propia del proyecto. Un conjunto típico:
- Etiquetas de hablante: E: para la persona que entrevista, P07: para el participante 7.
- Pausas: (pausa) para una pausa notoria, o (3s) si importa la duración.
- Habla superpuesta: márcala con [superposición] o empieza el turno superpuesto con una diagonal.
- Sonidos no verbales: [ríe], [suspira], [silencio largo].
- Habla poco clara: [inaudible 00:14:32] con marca de tiempo, o [poco claro: ¿palabra?] para la mejor suposición.
- Énfasis: MAYÚSCULAS o cursivas, con moderación.
- Datos ocultados: [nombre del pueblo], [empleador].
Incluye esta lista en la documentación del proyecto y en el encabezado de cada transcripción.
Lo básico de la notación de Jefferson
Quienes hacen análisis de la conversación usan el sistema de Jefferson, llamado así por Gail Jefferson. El tutorial de notación para análisis de la conversación de la Universidad de Loughborough (en inglés) resume los símbolos principales:
- (.) una micropausa apenas perceptible; (0.5) una pausa medida en segundos.
- [ alineado en líneas contiguas para el inicio del habla superpuesta, a veces ] para su final.
- = encadenamiento: sin espacio entre turnos.
- pa:labra sonido alargado; °palabra° habla en voz baja; mayúsculas para habla en voz alta.
- >palabra< habla más rápida;
habla más lenta. - ((se sorbe la nariz)) descripción de un sonido o una acción por parte de quien transcribe.
- ( ) habla poco clara; (palabra) lo que probablemente se escuchó, sin certeza.
Para el sistema completo, los textos de metodología citan el "Glossary of transcript symbols with an introduction" de Jefferson (2004) y Structures of Social Interaction de Atkinson y Heritage (1984). La transcripción de Jefferson es lenta y especializada; ninguna herramienta automática la produce de forma confiable, así que planea trabajo humano detallado si tu método la necesita.
Aprobación ética, consentimiento y protección de datos
Antes de que una grabación llegue a cualquier servicio de transcripción, revisa tres documentos:
- Tu aprobación ética. Puede indicar cómo y quién transcribe el audio. Usar un servicio externo, humano o con IA, puede requerir que lo declares o que se apruebe.
- El formulario de consentimiento del participante. Los participantes deben saber que las grabaciones se transcribirán, quién tendrá acceso, cuánto tiempo se guarda el audio y si las transcripciones anonimizadas podrán archivarse o compartirse.
- Tu plan de gestión de datos. Debe indicar dónde se guardan el audio y las transcripciones y cuándo se eliminan.
En la UE y el Reino Unido, las grabaciones de entrevistas son datos personales según el RGPD y a menudo contienen categorías especiales de datos, como salud, religión u opiniones políticas. En México, la legislación de protección de datos personales también las considera datos personales, y esos mismos temas entran en la categoría de datos sensibles. Cuando usas un servicio externo, este actúa como encargado del tratamiento, así que necesitas saber dónde procesa los datos, cuánto tiempo los conserva, si usa las grabaciones para entrenar modelos y si firma un contrato de encargo de tratamiento. Nuestro artículo sobre el RGPD y la transcripción repasa estos puntos a detalle.
Audiotexta, por ejemplo, permite programar el borrado y no usa el contenido de los usuarios para entrenar modelos; el plan Team incluye un DPA. La página de privacidad reúne los detalles, que puedes citar en una solicitud ante tu comité de ética. Uses la herramienta que uses, compárala con las reglas de tu institución; algunas universidades solo permiten proveedores aprobados.
Anonimización y seudonimización
Anonimiza durante la transcripción o justo después, no al final del proyecto. La guía del UK Data Service para anonimizar datos cualitativos (en inglés) recomienda planear la anonimización desde el principio, aplicarla de forma coherente y combinarla con el consentimiento y los controles de acceso, en lugar de confiar solo en tachar información.
Reglas prácticas:
- Los identificadores directos (nombres, direcciones, correos, teléfonos) se reemplazan por seudónimos o descripciones entre corchetes: "María" pasa a ser "Ana" o [nombre de una colega].
- Los identificadores indirectos (edad exacta, puestos poco comunes, pueblos pequeños, sucesos inusuales) pueden identificar a alguien si se combinan. Generalízalos: "una enfermera de cuarenta y tantos en un pueblo del norte".
- Sé coherente. La misma persona o el mismo lugar recibe el mismo reemplazo en todas las transcripciones.
- Lleva una clave. Registra cada reemplazo en un registro guardado aparte de las transcripciones, con acceso restringido.
- No tapes el texto. Los reemplazos mantienen la transcripción legible; las barras negras no.
- No anonimices de más. Quitar demasiado contexto puede dejar los datos inservibles para el análisis.
Recuerda que, según el RGPD, los datos seudonimizados siguen siendo datos personales mientras exista una clave. Solo cuentan como anónimos los datos que ya no se pueden vincular con una persona.
Revisión de exactitud: borrador con IA y una revisión humana
La transcripción manual es lenta. Un rango que se cita con frecuencia es de cuatro a seis horas de trabajo por hora de audio para una transcripción literal sencilla, y mucho más con notación detallada o grupos focales con ruido. La transcripción automática cambia el flujo de trabajo: la máquina produce un borrador en minutos y el tiempo de quien investiga se va en revisarlo.
Una rutina de revisión que funciona:
- Genera el borrador con etiquetas de hablantes y marcas de tiempo. Los modelos de la clase de Whisper funcionan bien con audio claro, pero todavía se equivocan con nombres, tecnicismos, acentos y voces que se enciman.
- Escucha toda la grabación mientras lees. Un editor que resalta las palabras durante la reproducción y te deja hacer clic en una palabra para saltar a ella hace esto mucho más rápido.
- Corrige primero los cambios de turno, luego las palabras y después agrega tus convenciones (pausas, superposiciones, notas no verbales).
- Marca la incertidumbre en lugar de adivinar: [poco claro 00:21:05].
- Haz una segunda revisión por muestreo, o pídele a un colega que revise una transcripción por lote.
La revisión suele tomar al menos lo mismo que dura la grabación, y a menudo más. También es una forma valiosa de familiarizarte con tus datos, algo que muchos métodos cualitativos consideran la primera etapa del análisis. Nuestros consejos para mejorar la precisión de la transcripción explican cómo las condiciones de grabación afectan el borrador.
Plantilla de encabezado para transcripciones
Empieza cada transcripción con el mismo encabezado para que los archivos se puedan identificar sin revelar quién es el participante.
| Campo | Ejemplo |
|---|---|
| Proyecto | Estudio sobre trabajo remoto y bienestar, ref. ética 2026/114 |
| ID de transcripción | ENT-07 |
| Participante | P07 (seudónimo: "Ana") |
| Entrevistador/a | E1 |
| Fecha y modalidad | 12/09/2026, videollamada |
| Duración | 00:52:40 |
| Idioma | Español |
| Estilo de transcripción | Literal limpia, convenciones del proyecto v1.2 |
| Transcrito por / revisado por | Borrador con IA, revisado por E1 |
| Anonimización | Nombres, empleador y pueblo reemplazados; clave guardada aparte |
| Notas | Cortes de audio en 00:31:10 y 00:44:02 |
Cómo transcribir una entrevista para codificarla: formato y exportación
El formato de transcripción de entrevista que mejor funciona para codificar es sencillo: un párrafo por turno de habla, una etiqueta de hablante al inicio y una marca de tiempo al principio de cada turno o a intervalos regulares.
- NVivo importa transcripciones en DOCX o TXT en Windows, con marcas de tiempo al inicio de los párrafos o en una columna de tabla, y acepta formatos como hh:mm:ss. NVivo para Mac importa transcripciones como texto plano, así que revisa la página de ayuda de tu versión.
- ATLAS.ti importa transcripciones en DOCX, RTF y TXT y, en las versiones actuales, archivos SRT y VTT, y puede sincronizar la transcripción con el audio para reproducirla.
- MAXQDA importa transcripciones con marcas de tiempo desde archivos DOCX o RTF y también admite SRT y VTT, con una lista de formatos de marca de tiempo de las herramientas de transcripción más comunes.
Con Audiotexta puedes exportar TXT, SRT o VTT en el plan gratuito, sin cuenta, y DOCX con Pro. SRT o VTT suele ser el camino más rápido para llegar a ATLAS.ti o MAXQDA, porque las marcas de tiempo vienen en el archivo. Para NVivo, exporta DOCX o TXT con marcas de tiempo y comprueba que coincidan con un formato que NVivo reconozca antes de importar un lote completo. Empieza en la aplicación web con una entrevista y prueba la importación antes de transcribir las demás.
Una vez que la transcripción está importada, vinculada al audio y anonimizada, puedes empezar a codificar con la confianza de que cada cita se puede rastrear hasta un momento de la grabación.
Cómo preparar la transcripción de una entrevista para codificarla
- Decide el estilo de transcripción. Elige literal, literal limpia o un sistema de notación como el de Jefferson según tu método, y pon las convenciones por escrito antes de empezar a transcribir.
- Crea un borrador con IA. Sube la grabación a una herramienta de transcripción con etiquetas de hablantes y marcas de tiempo, usando un servicio que permitan tu aprobación ética y tu plan de gestión de datos.
- Revisa el borrador contra el audio. Escucha la grabación completa, corrige palabras, nombres y cambios de turno, y agrega las pausas, superposiciones o notas no verbales que pidan tus convenciones.
- Seudonimiza la transcripción. Reemplaza los nombres y los datos que identifican a alguien por seudónimos coherentes o descripciones entre corchetes, y anota cada cambio en una clave que se guarde aparte de los datos.
- Agrega un encabezado y guarda en un formato listo para importar. Agrega un encabezado con el ID del participante, la fecha, la duración y las convenciones, y guarda en DOCX o TXT con marcas de tiempo, o en SRT o VTT si tu software de análisis lo acepta.
- Importa a tu software de análisis. Importa la transcripción a NVivo, ATLAS.ti o MAXQDA, vincúlala con el audio si necesitas reproducción sincronizada y empieza a codificar.
Preguntas frecuentes
¿Qué diferencia hay entre la transcripción literal y la literal limpia?
La transcripción literal registra todo lo que se dice, incluidas muletillas, arranques en falso, repeticiones y, a menudo, pausas. La literal limpia (o verbatim inteligente) conserva el sentido y las palabras de quien habla, pero quita muletillas y tartamudeos y ordena un poco las frases que se alargan; se lee mejor, pero pierde rasgos que algunos métodos analizan.
¿Qué estilo de transcripción conviene para un análisis temático?
Muchos proyectos de análisis temático usan literal limpia o un estilo literal ligero, porque el foco está en lo que dicen los participantes más que en cómo lo dicen. El análisis de la conversación y el análisis del discurso suelen requerir transcripción literal detallada con notación para pausas y superposiciones. Elijas lo que elijas, descríbelo en tu apartado de metodología.
¿Cuánto tiempo toma transcribir una hora de entrevista?
Un rango que se cita con frecuencia para la transcripción manual es de cuatro a seis horas por hora de audio con un estilo literal sencillo, y bastante más con notación detallada como la de Jefferson. Partir de un borrador automático suele acortar ese tiempo, pero la revisión humana sigue tomando al menos lo mismo que dura la grabación.
¿Puedo usar transcripción con IA para entrevistas de investigación?
Muchas veces sí, si tu aprobación ética, tus formularios de consentimiento y tu plan de gestión de datos lo permiten. Revisa dónde procesa y guarda el audio el servicio, si usa tus datos para entrenar modelos y si tu institución exige un contrato de encargo de tratamiento de datos.
¿NVivo, ATLAS.ti y MAXQDA aceptan transcripciones con marcas de tiempo?
Sí. NVivo importa transcripciones en DOCX y TXT con marcas de tiempo en Windows, y en TXT en Mac. ATLAS.ti y MAXQDA importan transcripciones en DOCX, RTF y TXT con marcas de tiempo y también aceptan archivos de subtítulos SRT y VTT. Revisa el formato exacto de marca de tiempo que espera tu versión.
Pruebe Audiotexta gratis
Suba un archivo o pegue un enlace y obtenga una transcripción en minutos.